ClaudeBot, GPTBot, ChatGPT-User: welcher KI-Crawler was tut
KI-Anbieter schicken bis zu drei Crawler: fürs Training, für ihre Suche und für die Antwort an eine Person. Welcher welcher ist, was die robots.txt bewirkt.
Veröffentlicht am Zuletzt geprüft am
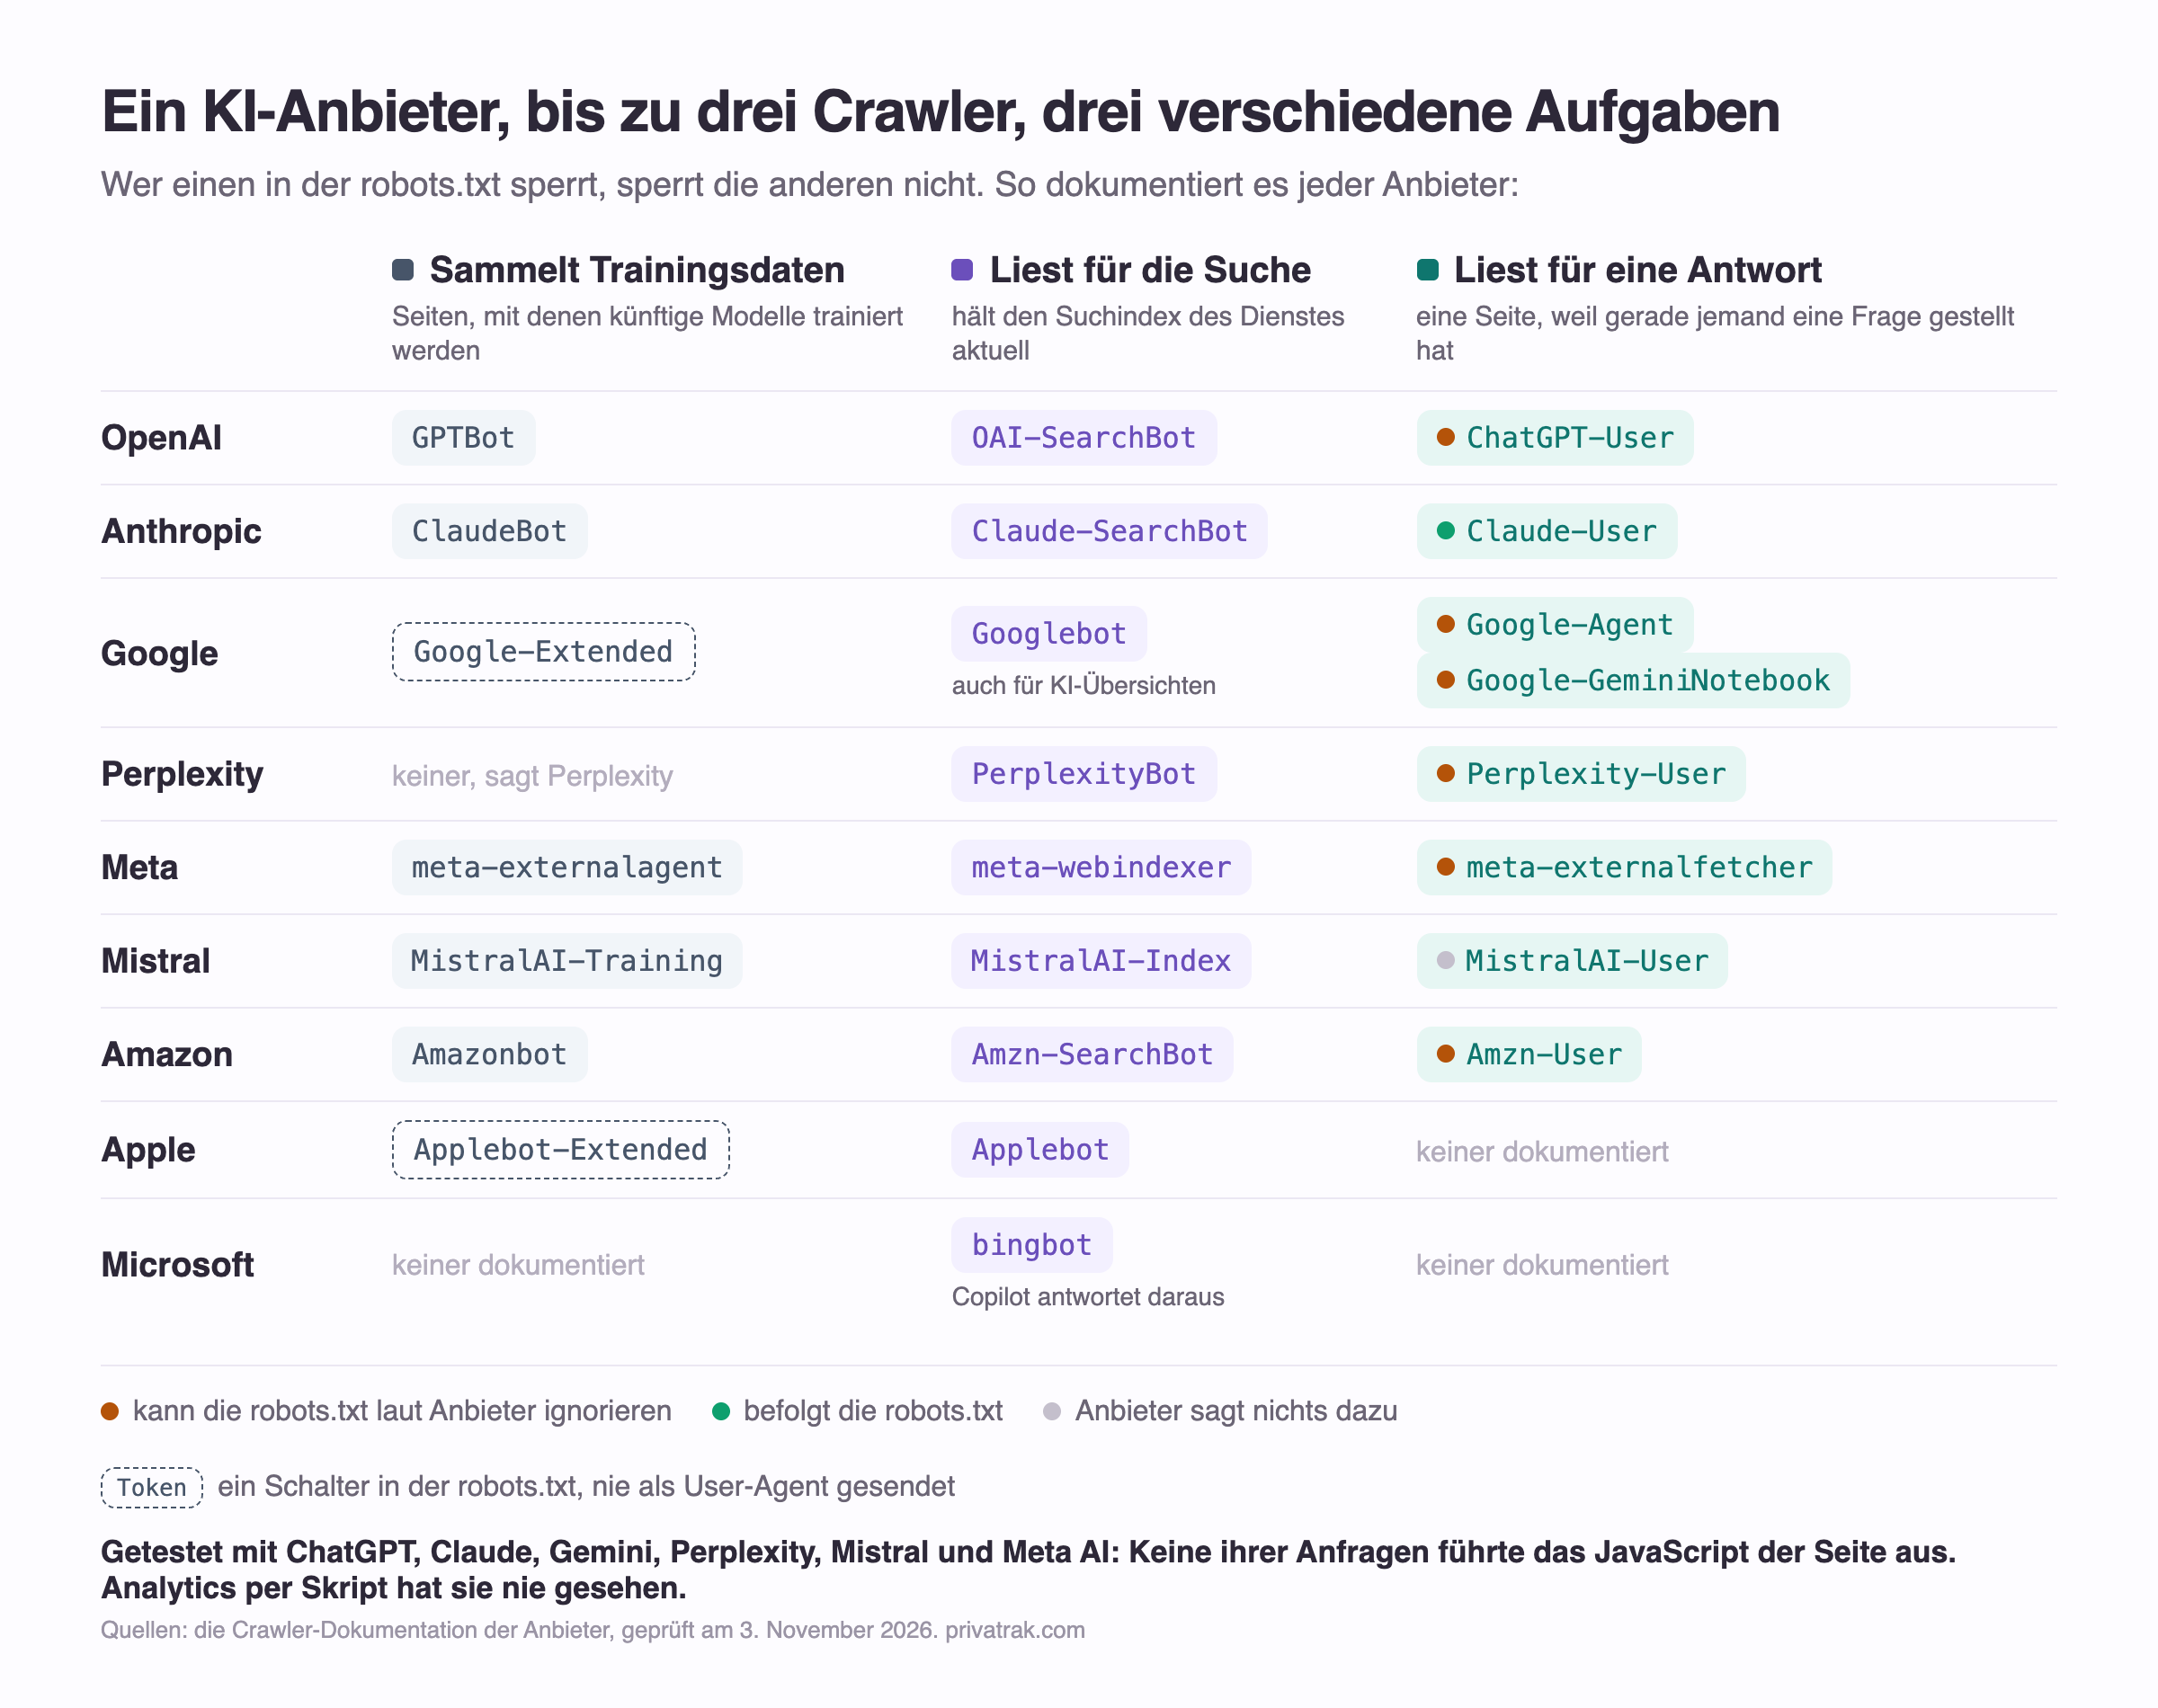
Wer in sein Server-Log schaut, findet Namen wie ClaudeBot, GPTBot, ChatGPT-User, OAI-SearchBot und meta-externalagent. Das sind KI-Crawler, und sie tun nicht alle dasselbe. Die meisten KI-Anbieter schicken bis zu drei davon, jeden für eine andere Aufgabe.
Einer sammelt Seiten, um künftige Modelle zu trainieren. Einer hält den Suchindex des Anbieters aktuell. Und einer liest genau eine Seite, jetzt sofort, weil eine Person ChatGPT oder Claude gerade etwas gefragt hat, das diese Seite beantwortet. Welcher es ist, entscheidet, was eine Sperre bewirkt, ob er Ihre robots.txt beachtet und ob Ihre Analytics ihn je zu sehen bekommt. Unten steht, was jeder Anbieter dokumentiert, und was in fünf Tagen tatsächlich auf unserer eigenen Website ankam.
Drei Aufgaben, drei Crawler
Trainingsdaten sammeln. GPTBot, ClaudeBot, meta-externalagent und ähnliche kopieren öffentliche Seiten in die Daten, aus denen künftige Modelle lernen. Sie crawlen nach dem Zeitplan des Anbieters, nicht weil jemand etwas gefragt hat. Wer sie sperrt, hält seine Seiten aus künftigen Trainingsdaten heraus. Bereits Gesammeltes bleibt, und derselbe Anbieter kann Ihre Seiten weiterhin finden und zitieren.
Für die Suche lesen. OAI-SearchBot, Claude-SearchBot und PerplexityBot bauen den Suchindex, aus dem der KI-Dienst antwortet, so wie Googlebot es für Google tut. Eine Seite, die nicht in diesem Index steht, kann bei einer Frage nicht auftauchen. Wer einen Such-Crawler sperrt, verschwindet aus den Antworten dieses Dienstes, und das will kaum ein Website-Betreiber.
Für eine Antwort lesen. ChatGPT-User, Claude-User und Perplexity-User fragen eine Seite in dem Moment an, in dem eine Person sie braucht: Jemand hat Ihren Link eingefügt, oder der Dienst hat entschieden, dass Ihre Seite die Frage beantwortet. Jede Anfrage ist die Frage einer Person. Näher an einen Besuch kommt ein KI-Dienst nicht, und genau das zeigt Ihre Analytics nie (mehr dazu weiter unten).
Jede Aufgabe hat ihren eigenen Namen in der robots.txt. OpenAI und Perplexity schreiben ausdrücklich, dass jede Einstellung für sich gilt, und Anthropic beschreibt für jeden seiner drei Crawler einzeln, was eine Sperre bewirkt. Wer GPTBot sperrt, ändert nichts an der Suche und den Antworten von ChatGPT.
Alle KI-Crawler nach Anbieter
Was jeder Anbieter über seine Crawler dokumentiert, wo es darauf ankommt mit seinen eigenen Worten (im englischen Original). Die Seite jedes Anbieters ist verlinkt; dort steht es, wenn sich ein Name ändert.
OpenAI: GPTBot, OAI-SearchBot und ChatGPT-User
GPTBot sammelt Trainingsdaten: Wer ihn sperrt, zeigt laut OpenAI an, dass die Inhalte nicht für das Training von KI-Basismodellen verwendet werden sollen. OAI-SearchBot baut die Suche von ChatGPT, und Seiten, die ihn sperren, „will not be shown in ChatGPT search answers“. ChatGPT-User liest eine Seite, wenn jemand ChatGPT oder ein eigenes GPT etwas fragt, und weil eine Person das ausgelöst hat, gilt die robots.txt dafür womöglich nicht („may not apply“). OpenAI ergänzt: Wer GPTBot und OAI-SearchBot beide erlaubt, bei dem kann ein Crawl für beide Zwecke dienen. Änderungen an der robots.txt erreichen die Suche nach etwa 24 Stunden. Crawler-Seite von OpenAI
Anthropic: ClaudeBot, Claude-SearchBot und Claude-User
ClaudeBot sammelt Trainingsdaten. Eine Sperre bedeutet laut Anthropic, dass künftige Inhalte der Website nicht in die Trainingsdaten kommen. Er beachtet auch Crawl-delay, falls er seltener kommen soll. Claude-SearchBot baut die Suche von Claude, und Claude-User liest eine Seite, wenn jemand Claude etwas fragt. Anthropic sagt, dass alle drei die robots.txt befolgen, und dass eine Sperre von Claude-User verhindert, dass Ihre Inhalte für die Frage einer Person abgerufen werden. Damit ist Anthropic der einzige der großen Anbieter, dessen Antwort-Crawler die robots.txt beachtet, und unser eigener Test bestätigt das: Claude hat die robots.txt eine Sekunde vor der Seite angefragt. ClaudeBot ist außerdem schnell: Auf unserer Testseite kam er wenige Minuten nach Ausstellung des TLS-Zertifikats, bevor irgendjemand den Link hatte. Crawler-Seite von Anthropic
Google: Googlebot, Google-Extended und die Gemini-Crawler
Google hat keinen eigenen Crawler für KI-Training. Google-Extended ist ein „standalone product token“: ein Name für die robots.txt, mit dem Sie festlegen, ob Seiten, die Googlebot ohnehin gecrawlt hat, Gemini trainieren und seine Antworten stützen dürfen. Keine Anfrage trägt diesen Namen, und er hat keinen Einfluss darauf, ob eine Website in der Google-Suche erscheint. KI-Übersichten erwähnt Google dort nicht; sie entstehen aus dem normalen Suchindex, den Googlebot aufbaut. Für das Lesen im Auftrag einer Person nennt Google Google-Agent (Agenten, die auf Wunsch einer Person surfen und handeln) und Google-GeminiNotebook (Seiten, die jemand als Quelle hinzugefügt hat), neben weiteren von Personen ausgelösten Abrufen, die die robots.txt „generally ignore“. Die Gemini-App selbst steht nicht auf der Liste: In unserem Test hat sie die Seite als schlichtes Google gelesen. Googles allgemeine Crawler, von Nutzern ausgelöste Abrufe
Perplexity: PerplexityBot und Perplexity-User
PerplexityBot baut die Suche von Perplexity und wird laut Perplexity nicht für das Training von KI-Modellen eingesetzt; einen Trainings-Crawler dokumentiert Perplexity nicht. Perplexity-User liest eine Seite für die Frage einer Person und ignoriert die robots.txt „generally“. In unserem Test hat Perplexity die Frage einer Person allerdings mit PerplexityBot beantwortet: Der Name des Such-Crawlers kann also auf einer Anfrage stehen, die eigentlich für eine Antwort war. Crawler-Seite von Perplexity
Meta: meta-externalagent, meta-webindexer und meta-externalfetcher
meta-externalagent crawlt, um KI-Basismodelle zu trainieren oder Produkte durch direktes Indexieren zu verbessern. meta-webindexer verbessert die Suchergebnisse in Meta AI und hilft laut Meta dabei, Ihre Inhalte zu zitieren und zu verlinken. meta-externalfetcher liest einzelne Links auf Wunsch einer Person und kann die robots.txt umgehen („may bypass“). Wie bei Perplexity hat Meta AI in unserem Test eine Frage mit meta-webindexer beantwortet. Die Link-Vorschauen in Facebook, Instagram und WhatsApp kommen von einem vierten Namen, facebookexternalhit. Crawler-Seite von Meta
Mistral, Amazon, Apple und Microsoft
Mistral hat die klarsten Namen: MistralAI-Training, MistralAI-Index und MistralAI-User. Ob MistralAI-User die robots.txt befolgt, sagt Mistral nicht; in unserem Test hat er sie einmal gelesen und dann jede Seite zweimal in derselben Sekunde. Seite von Mistral
Amazon schickt Amazonbot, der „may be used to train Amazon AI models“, Amzn-SearchBot für die Suche und Amzn-User für Fragen wie die an Alexa, der nicht alle Regeln der robots.txt befolgt („may not follow all“). Amazonbot dient mehr als nur dem Training, eine Sperre kostet also mehr als ein Opt-out aus dem Training. Seite von Amazon
Apple crawlt mit Applebot für Siri, Spotlight und Safari. Applebot-Extended ist wie Google-Extended nur ein Name für die robots.txt: Er „does not crawl webpages“, und wer ihn sperrt, hält seine Seiten aus dem Training von Apples Modellen heraus, bleibt aber in der Suche. Seite von Apple
Microsoft dokumentiert keinen eigenen KI-Crawler. Copilot antwortet aus dem Index von Bing, den bingbot aufbaut. Wer bingbot sperrt, verschwindet also aus Bing und Copilot zugleich.
Die, die nichts sagen
Manche KI-Dienste dokumentieren nichts, was wir prüfen konnten. Bytespider ist der Crawler von ByteDance; ob er die robots.txt beachtet, darüber gehen die Berichte auseinander. xAI dokumentiert keinen Crawler für Grok, und in unserem Test sah der Browser-Agent von Grok genau aus wie das Chrome einer Person, über deren eigenen Anschluss. DeepSeek hat unsere Seite in einem vollständigen Browser mit gewöhnlichem Firefox-User-Agent gelesen. In keiner Log-Zeile steht einer der beiden mit Namen.
Was in fünf Tagen tatsächlich auf unserer Website ankam
Vom 29. Oktober bis 2. November 2026 hat unser Server jede Anfrage von Crawlern an privatrak.com und seine Subdomains gemeldet: 3.785 Anfragen. 1.661 davon, 44 %, trugen den Namen eines KI-Crawlers.
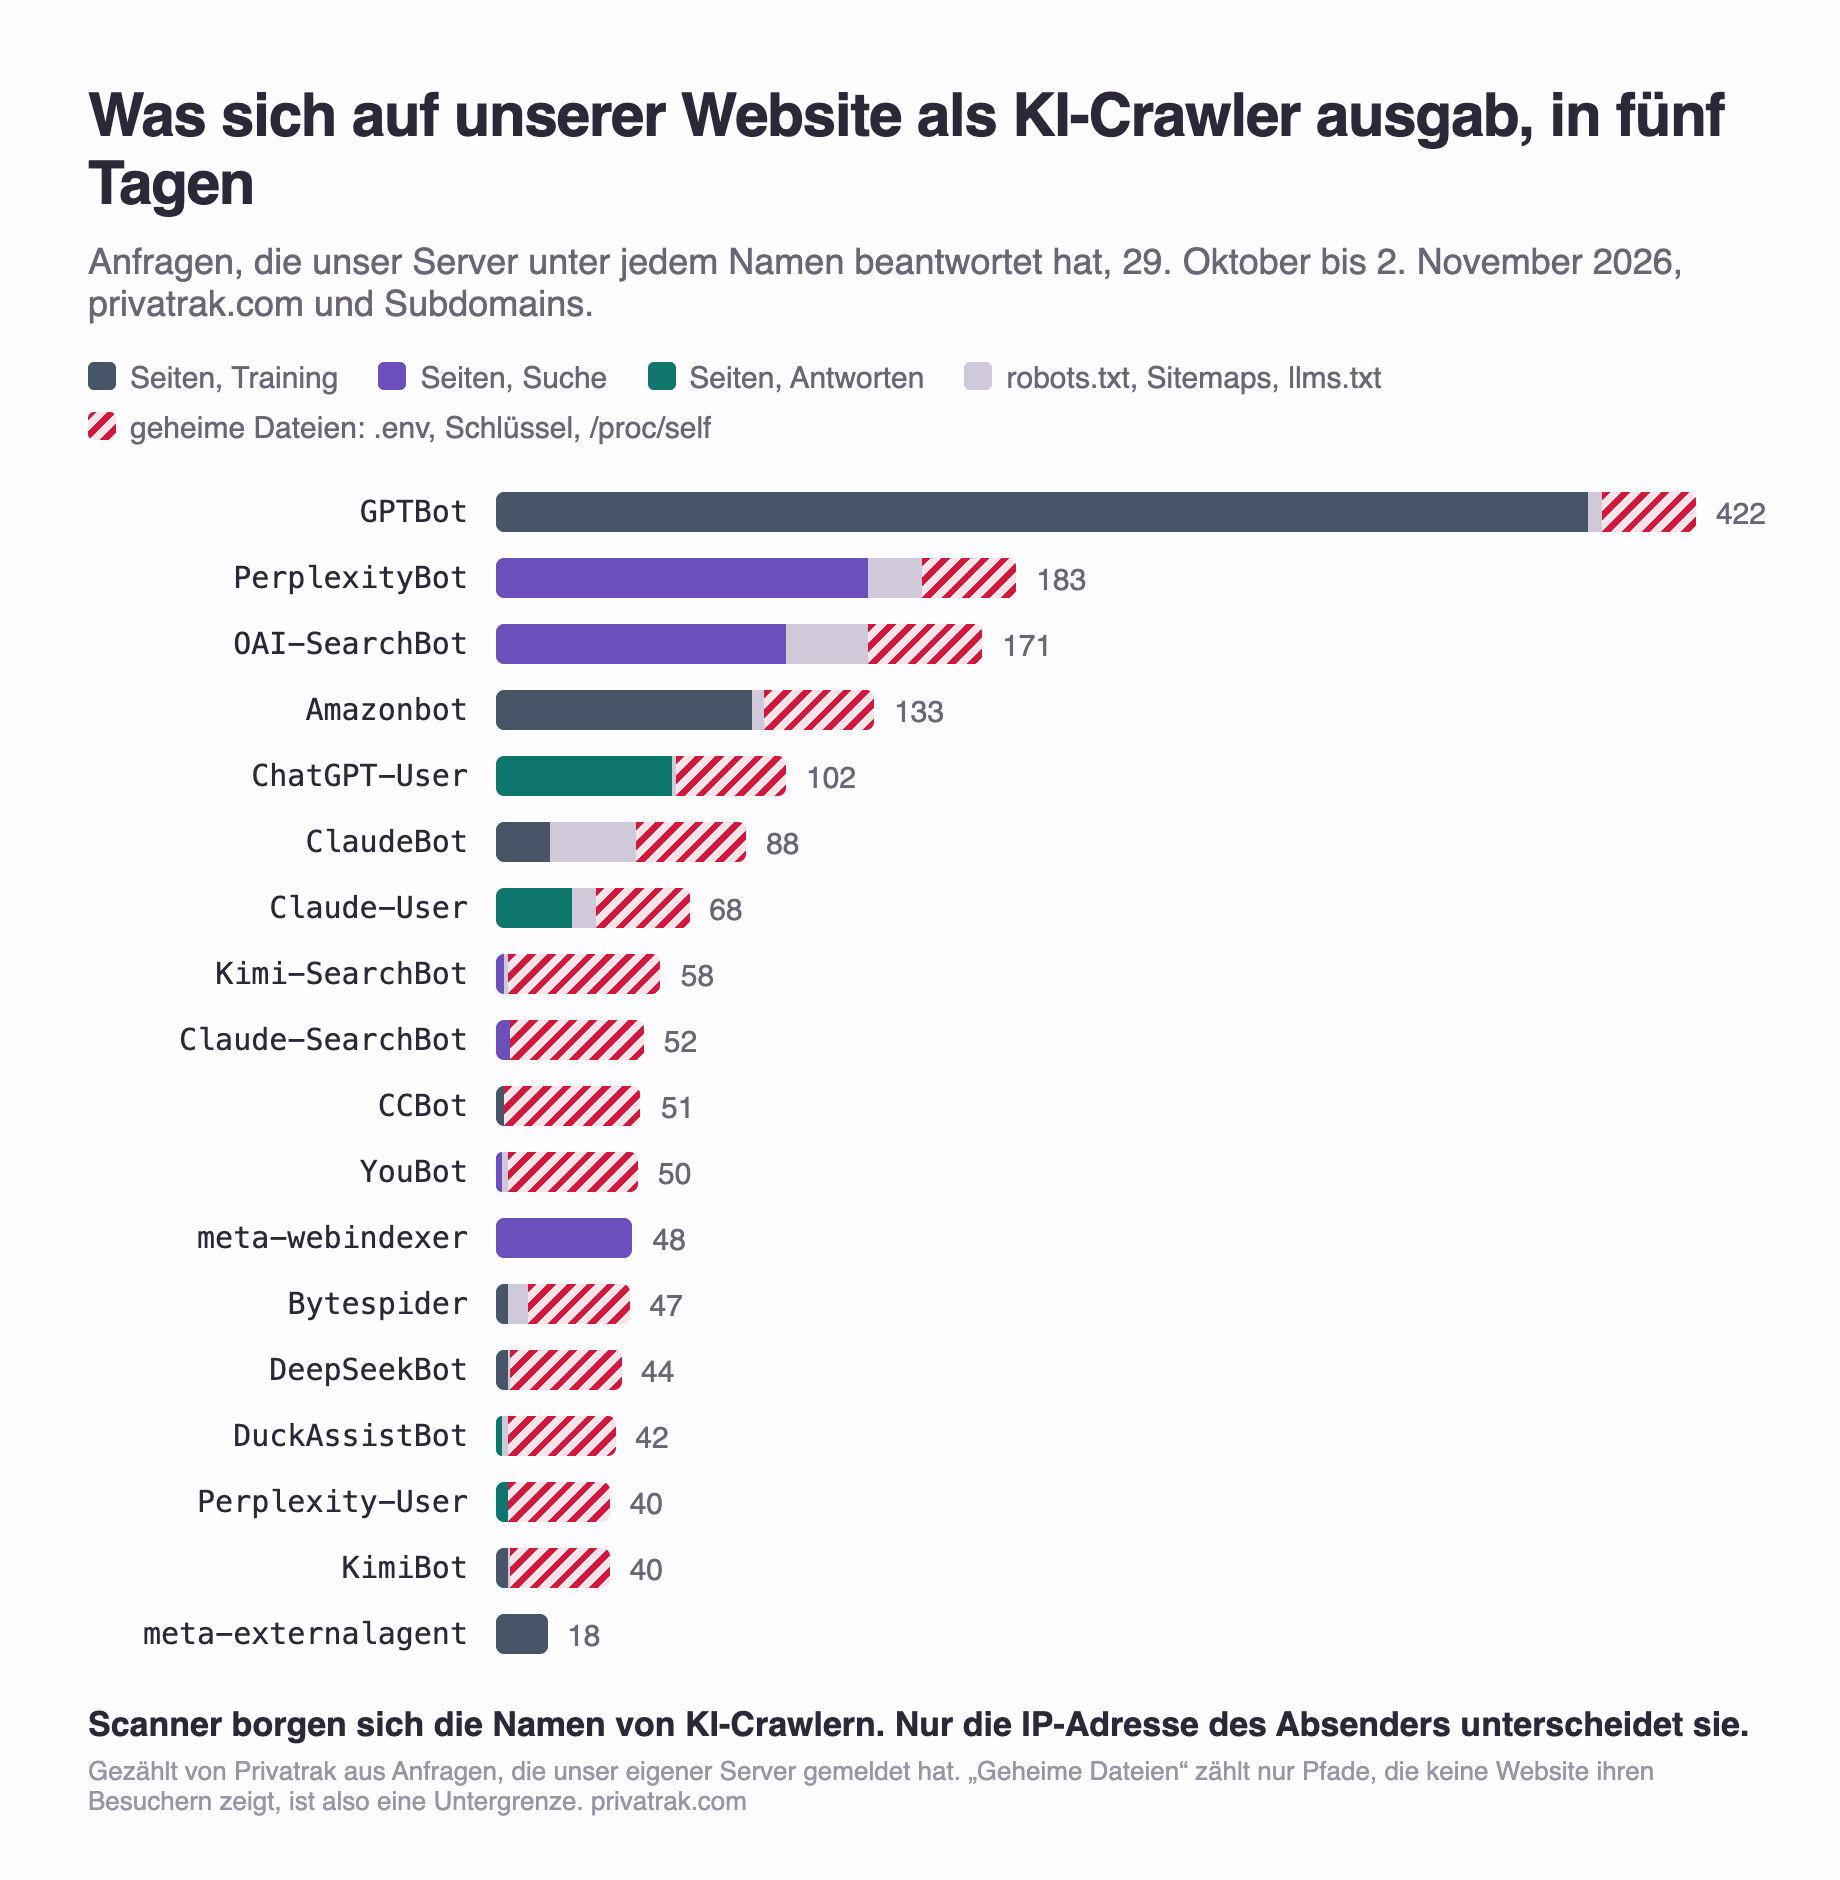
Das Training lag vorn. GPTBot hat in fünf Tagen 384 Seiten angefragt, mehr als jeder andere Crawler, Suchmaschinen eingeschlossen: Bingbot fragte 297 an, Googlebot 133.
Antworten waren der kleinere Teil, und der wertvollste. ChatGPT-User hat 62 Seiten angefragt und Claude-User 27, jede davon die Frage einer Person, die unsere Seite beantwortet hat. 46 der Anfragen von ChatGPT galten der Startseite.
Mindestens 635 der 1.661 Anfragen mit KI-Namen, 38 %, kamen gar nicht von KI-Crawlern. Sie fragten nach .env-Dateien, /proc/self/environ, privaten Schlüsseln und docker-compose.yml: Dateien, die keine Website ihren Besuchern zeigt und die Scanner in der Hoffnung auf ein offenliegendes Passwort ausprobieren. Unter den Namen der Antwort-Crawler gab es davon mehr (146) als Anfragen nach Seiten (97). Perplexity-User fragte 36 von 40 Mal nach einer geheimen Datei, DuckAssistBot 38 von 42 Mal, Claude-SearchBot 47 von 52 Mal. Die Namen von Meta hat sich niemand geborgt, ausgerechnet die des einzigen großen Anbieters, dessen Crawler sich nicht anhand einer veröffentlichten IP-Liste prüfen lassen.
Die llms.txt wurde kaum gelesen. Über alle Crawler hinweg wurde sie in fünf Tagen dreimal angefragt: je einmal von GPTBot, Googlebot und GoogleOther. ClaudeBot dagegen hat 30 Mal die robots.txt angefragt und dabei 19 Seiten.
Eine Website, fünf Tage. Die 38 % sind eine Untergrenze: Sie zählen nur Anfragen nach Dateien, die nie eine Seite sind. Ein Scanner, der unter dem Namen von ChatGPT nach /admin fragt, zählt also als Anfrage nach einer Seite.
Was die robots.txt kann und was nicht
Die robots.txt ist eine Bitte, kein Schloss. Die Trainings- und Such-Crawler der Anbieter oben sagen, dass sie sie befolgen. Die Crawler, die für eine Antwort lesen, sagen meist, dass sie es vielleicht nicht tun, weil eine Person gefragt hat: OpenAI, Google, Perplexity, Meta und Amazon schreiben das alle auf die eine oder andere Weise. Anthropic ist die Ausnahme.
Die Wahl, die Ihnen die robots.txt lässt, betrifft also vor allem das Training. Wer aus Trainingsdaten heraus, aber weiter in KI-Antworten auftauchen will, sperrt die Namen fürs Training und lässt den Rest in Ruhe:
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: MistralAI-Training
User-agent: Amazonbot
User-agent: CCBot
Disallow: /
CCBot ist Common Crawl, dessen öffentliches Archiv viele Modelle zum Training nutzen. Amazonbot steht dabei, weil Amazon mit dem Gesammelten trainieren kann; er versorgt aber auch andere Amazon-Produkte, lassen Sie ihn also weg, wenn Ihnen das wichtig ist. Rechnen Sie mit einem Tag, bis eine Änderung wirkt: OpenAI und Perplexity nennen etwa 24 Stunden, Meta speichert die robots.txt bis zu 24 Stunden zwischen und Amazon bis zu 30 Tage.
Warum Ihre Analytics nichts davon zeigt
Analytics-Tools wie Google Analytics, Plausible oder Privatrak zählen einen Besuch, wenn das JavaScript der Seite in einem Browser läuft. Ein Crawler, der die Seite als Text liest, führt es nie aus. Als wir KI-Dienste auf eine Testseite geschickt haben, haben ChatGPT, Claude, Gemini, Perplexity, Mistral und Meta AI die Seite gelesen, ohne ein einziges Skript auszuführen. Keiner kam in unserer Analytics an, auch nicht in Google Analytics.
Unsere eigene Website bestätigt das. In den fünf Tagen oben haben ChatGPT-User, Claude-User und die anderen Antwort-Crawler 97 Seiten angefragt und keinen einzigen Seitenaufruf in unserer Analytics hinterlassen. Such-Crawler führen das Skript manchmal doch aus: OAI-SearchBot tauchte 4 Mal auf, meta-webindexer 10 Mal.
Bei Trainings- und Such-Crawlern ist das in Ordnung, die wollen Sie ohnehin nicht in Ihren Besucherzahlen. Bei den Antwort-Crawlern ist es eine echte Lücke. Jede ihrer Anfragen ist eine Person, die einem KI-Dienst eine Frage stellt, die Ihre Seite beantwortet, und diese Zahl lohnt sich. Sie zeigt, ob KI-Dienste Sie überhaupt lesen, welche Seiten, und ob daraus Besucher werden, die sich durchklicken.
Diese Anfragen sieht nur Ihr Server. Ihr Server-Log enthält sie, ebenso ein Log Ihres CDN. Privatrak kann sie zählen, wenn Ihr Server die Anfragen meldet, die er beantwortet: eine Einstellung im WordPress-Plugin, ein Cloudflare Worker oder ein paar Zeilen in Next.js oder Nuxt. Ihr Server meldet nur Anfragen bekannter Crawler, nichts über Ihre Besucher verlässt ihn. Die Seite KI-Dienste zeigt dann, wie oft ChatGPT, Claude und die anderen Ihre Seiten für eine Antwort gelesen haben, neben den Besuchern, die sie Ihnen geschickt haben.
Ist es wirklich ClaudeBot? Prüfen Sie die IP-Adresse
Ein User-Agent ist eine Behauptung, und die kann jeder aufstellen. Google sagt es selbst: User-Agents „can be spoofed“. Auf unserer eigenen Website waren mindestens 38 % der Anfragen mit dem Namen eines KI-Crawlers Scanner (siehe oben), die sich einen Namen borgen, den Websites gern durchlassen.
Die einzige verlässliche Prüfung ist die Adresse, von der die Anfrage kommt. Die meisten Anbieter veröffentlichen die IP-Bereiche ihrer Crawler, und eine Anfrage von außerhalb ist nicht dieser Crawler, was immer sie behauptet:
| Anbieter | Crawler | IP-Listen |
|---|---|---|
| OpenAI | GPTBot, OAI-SearchBot, ChatGPT-User | gptbot.json, searchbot.json, chatgpt-user.json |
| Anthropic | ClaudeBot, Claude-SearchBot, Claude-User | bots.json |
| Googlebot, Google-Agent, Google-GeminiNotebook | googlebot.json, user-triggered-fetchers-google.json, user-triggered-agents.json | |
| Perplexity | PerplexityBot, Perplexity-User | perplexitybot.json, perplexity-user.json |
| Mistral | MistralAI-Index, MistralAI-User | mistralai-index-ips.json, mistralai-user-ips.json |
| Amazon | Amazonbot, Amzn-SearchBot, Amzn-User | Amazonbot, Amzn-SearchBot, Amzn-User |
| Apple | Applebot | applebot.json |
| Microsoft | bingbot | bingbot.json |
| Meta | meta-externalagent, meta-webindexer, meta-externalfetcher | keine veröffentlicht |
OpenAI
- Crawler
- GPTBot, OAI-SearchBot, ChatGPT-User
- IP-Listen
- gptbot.json, searchbot.json, chatgpt-user.json
Anthropic
- Crawler
- ClaudeBot, Claude-SearchBot, Claude-User
- IP-Listen
- bots.json
- Crawler
- Googlebot, Google-Agent, Google-GeminiNotebook
Perplexity
- Crawler
- PerplexityBot, Perplexity-User
- IP-Listen
- perplexitybot.json, perplexity-user.json
Mistral
- Crawler
- MistralAI-Index, MistralAI-User
Amazon
- Crawler
- Amazonbot, Amzn-SearchBot, Amzn-User
- IP-Listen
- Amazonbot, Amzn-SearchBot, Amzn-User
Apple
- Crawler
- Applebot
- IP-Listen
- applebot.json
Microsoft
- Crawler
- bingbot
- IP-Listen
- bingbot.json
Meta
- Crawler
- meta-externalagent, meta-webindexer, meta-externalfetcher
- IP-Listen
- keine veröffentlicht
Alle Listen waren am 3. November 2026 erreichbar. Für MistralAI-Training veröffentlicht Mistral keine. Google und Microsoft beschreiben zusätzlich eine Prüfung per Reverse DNS, und Bing hat ein Werkzeug Verify Bingbot.
Meta ist der einzige große Anbieter, der keine Liste veröffentlicht. Eine Anfrage, die sich meta-externalagent nennt, lässt sich so also nicht prüfen. Die Listen ändern sich außerdem, eine Firewall-Regel daraus muss also regelmäßig erneuert werden. Anthropic warnt, dass eine Sperre per IP nicht verlässlich oder dauerhaft als Opt-out wirkt: Die Listen sind dafür da zu prüfen, von wem eine Anfrage kommt; was Sie wollen, sagen Sie in der robots.txt.
Kurz gesagt
- Ein KI-Anbieter, bis zu drei Crawler: einer fürs Training, einer für seine Suche, einer, der für die Antwort an eine Person liest. Jeder hat seinen eigenen Namen in der robots.txt.
- Wer einen Trainings-Crawler sperrt, bleibt aus künftigen Trainingsdaten heraus, sonst ändert sich nichts. Wer einen Such-Crawler sperrt, verschwindet aus den Antworten des Dienstes.
- Crawler, die für eine Antwort lesen, befolgen die robots.txt meist nicht. Der von Anthropic schon.
- Keiner der getesteten KI-Dienste hat das JavaScript der Seite ausgeführt. Nur Ihr Server sieht sie.
- Auf unserer Website waren mindestens 38 % der Anfragen unter Namen von KI-Crawlern Scanner auf der Suche nach Passwörtern, und die llms.txt wurde in fünf Tagen dreimal angefragt.
- Ein Name ist eine Behauptung. Die veröffentlichten IP-Listen sind die Prüfung.